

Täiustatud funktsiooniparameetrite ekstraheerimine kõnesignaalidest masinõppe algoritmi (2) abil
May 30, 2023
3.7. Andmekogum Andmekogumi kogumise ja genereerimise protsessid viidi läbi järgmiselt. Selles uuringus kasutati mudelitreeningu jaoks 120-tunnise heliga andmekogumit. Andmekogum sisaldab kõne helisalvestisi, mis koosnevad maksimaalselt 15-sõnalistest lausetest kogupikkusega ligikaudu 120 tundi.

Kõrbe ženšenn
Lisaks sisaldab andmestik suurel hulgal erinevat teksti, mida kasutada keelemudeli väljatöötamisel. Koguti üle 90 650 lausungi, 415 780 sõna ja 65 810 unikaalset sõna, mis sisaldusid tekstikorpuses, mille tulemusena saadi umbes 120 tundi transkribeeritud kõneandmeid. Jagasime andmestiku koolitus-, valideerimis- ja testikomplektideks. Andmekogumi statistika
on esitatud tabelis 3.
Tabel 3. Andmestiku spetsifikatsioonid.

Jagasime andmekogumi kolmeks kaustaks, mis vastavad koolitusele, valideerimisele ja testikomplektidele. Iga kaust sisaldab helisalvestisi ja ärakirju. Heli ja vastavate transkriptsioonifailide nimed on samad, välja arvatud see, et helisalvestised salvestatakse WAV-failidena, samas kui transkriptsioonid salvestatakse TXT-failidena, kasutades kodeeringut UTF-8. Kõik transkriptsioonid on esitatud ladina tähestikuga, mis koosneb 29 tähest ja apostroofist. Ülesobitamise vältimiseks rakendasime kiiruse häirimisel ja spektri suurendamisel põhinevaid andmete suurendamise tehnikaid.

Cistanche deserticola
4. Kavandatud meetod
Programmeerijate oluliseks ülesandeks kõnetuvastussüsteemide väljatöötamisel on optimaalse meetodi loomine kõnesignaalide parameetriliseks väljendamiseks [45]. See meetod võimaldab helide ja räägitud sõnade suurepärast eraldamist, tagades samal ajal, et kõnelejad on hääldusmustrite ja akustilise keskkonna muutuste suhtes tundlikud. Enamik vigu sõnade tuvastamisel on põhjustatud signaali kõrguse muutumisest, mis on tingitud mikrofoni nihkest või häälduse kõrguse erinevusest [46]. Teine levinud vigade põhjus on spektri kuju juhuslikud mittelineaarsed deformatsioonid, mis esinevad alati kõneleja kõnesignaalis [47,48]. Seetõttu on efektiivsete kõnetuvastussüsteemide loomisel üheks olulisemaks ülesandeks sellise esituse valimine, mis on nii analüüsitava signaali sisu jaoks piisav kui ka tundetu kõlarite häälte ja erinevate akustiliste keskkondade suhtes.

Cistanche toidulisand minu lähedal - mälu parandamine
Funktsiooni parameetrite eraldamiseks kasutataval süsteemil on tavaliselt järgmised nõuded. Infosisu ehk tunnuste parameetrite kogum peab tagama äratuntavate kõneelementide usaldusväärse tuvastamise. Lisaks tuleb minimeerida helitugevust, st helisignaali maksimaalset tihendamist ja parameetrite mittestatistilist korrelatsiooni. Samuti tuleb saavutada sõltumatus kõnelejast, see tähendab kõneleja omadustega seotud teabe maksimaalne eemaldamine tähemärkide vektorist. Lõpuks tuleb esitada homogeensus, mis viitab sama keskmise dispersiooniga parameetritele ja võimalusele kasutada märgikomplektide vahelise afiinsuse määramiseks lihtsaid mõõdikuid [49]. Siiski ei ole alati võimalik kõiki nõudeid üheaegselt täita, kuna need nõuded on vastuolulised. Kõneelementide parameetriline kirjeldus peaks olema piisavalt detailne, et neid usaldusväärselt eristada, ja võimalikult lakooniline.

Supermani ürtide cistanche
Praktikas digiteeritakse mikrofonist vastuvõetav kõnesignaal diskreetimissagedusega 8–22 kHz. Jadaarvväärtused jagunevad kõnefragmentideks (kaadriteks), mille kestus on 10–30 ms, mis vastavad kvaasistatsionaarsetele kõneosadele. Igast kaadrist arvutatakse funktsioonide vektor, mida kasutatakse seejärel kõnetuvastuse akustilisel tasemel. Praegu on autokorrelatsioonianalüüsil, riistvaralisel lineaarsel filtreerimisel, spektraalanalüüsil ja LPC-l põhinevate signaalide parameetriliseks esitamiseks saadaval lai valik meetodeid. Levinuim lähenemine kõne parameetristamisel on signaalifragmentide spektraalanalüüs ja nende tsestraalsete koefitsientide arvutamine.
MFCC-sid on kasutatud kõnesignaali informatiivsete funktsioonidena [41]. Neid omadusi kasutatakse kõnetuvastuses laialdaselt ja need põhinevad kahel põhikontseptsioonil: cepstral ja Mel skaala. Algoritmi peamised eelised on selle kõrge tuntus ja kõne lihtsus. MFCC funktsioonid on salvestatud kõnesignaalidest eraldatud. MFCC algoritm kasutab fonogrammi ja spektrivahetusalgoritmide tulemusi. MFCC-de arvutamiseks kasutatav klassikaline algoritm on kujutatud joonisel 5.

Joonis 5. Klassikaline MFCC arvutamise skeem.
See uuring pakub kiiret meetodit funktsiooni parameetrite eraldamiseks kõnesignaalist. MFCC-de kiireks arvutamiseks pakutud algoritm on näidatud joonisel 6.

Joonis 6. MFCC arvutamise kavandatav raamistik.
Vaatleme pakutud algoritmi täitmisjärjestust funktsiooni parameetrite kiireks eraldamiseks kõnesignaalist
4.1. Jagamine raamideks
Pärast eelfiltreerimist jagatakse kõnesignaal 16 ms kaadriteks. Iga kaader (välja arvatud esimene) sisaldab eelmise kaadri viimast 10 ms. See protsess jätkub kuni signaali lõpuni. Selles uuringus, kuna kõnesignaali diskreetimissagedus on 16 kHz, on kaadri pikkus N=256 ja nihke pikkus M=160. Kattuvus on 62,5 protsenti kaadri pikkusest. Üldiselt on soovitatav katta 50–75 protsenti kaadri pikkusest.
4.2. Hanningi aken ja väärtuste kahanemine
Kasutati Hanningi akna suurust 1D. Hanningi akent nimetatakse ka tõstetud koosinusaknaks. Hanningi akent võib pidada kolme ristkülikukujulise ajaakna sagedusspektri summaks. See võib kasutada külghõlmasid üksteise tühistamiseks, välistades kõrgsageduslikud häired ja energialekke. Hanning aknad on väga kasulikud aknafunktsioonid.

Cistanche toidulisand minu lähedal - mälu parandamine
Cistanche mälu parandavate ja Alzheimeri tõve ennetavate toodete vaatamiseks klõpsake siin
【Küsi lisa】 E-post:cindy.xue@wecistanche.com / Whats App: 0086 18599088692 / Wechat: 18599088692
Moonutuste vähendamiseks ja üksikute raamide silumiseks kasutatakse kaalukasti. Ujuv signaal, mida selles uuringus uuritakse, koosneb tihedast toonist. Tasapinnalise tooni ulatuse määrab puhta tooni suurus sagedusel f, mis filtreeritakse läbi Hanningi akna.
Selle akna kriitiline aspekt on see, et see seab raamide piirid nulli. Sel juhul saab lühikesed energiad arvutada läbi akna ja need saab üle kanda jadast, mida kasutatakse madalaima amplituudiga energiate arvutamiseks. Eesmärk on eemaldada signaalist madala energiatarbega signaale, arvutades signaali energia ja samal ajal siludes sellest aknast tulevat signaali. See protsess nõuab järgmist signaalienergia võrrandit:

kus En on sisendsignaali fragmendi energia ja xi on signaali väärtus.
Lisaks aknaprotsessile, kasutades (11), töödeldakse signaali järgmises etapis, mis vähendab oluliselt protsessorisse sisenevate väärtuste arvu. Joonisel 7 on kujutatud paralleeltöötluse algoritm.
Akna suurus tähistab näidiste arvu ja kestust. See on analüüsi peamine parameeter. Akna suurus sõltub põhisagedusest, intensiivsusest ja signaali muutustest.

Joonis 7. Hanningi akna algoritm vaiksete osade eemaldamiseks. 4.3. Lühiajalised Fourier' teisendused (STFT) lülitid Kõrge või madala kõrguse tähendusest on intuitiivne arusaam. STFT on Fourier'ga seotud teisendus, mida kasutatakse signaali kohalike osade siinuse sageduse ja faasisisalduse määramiseks, kui see aja jooksul muutub. Praktikas hõlmab STFT arvutus pikema aja signaali jagamist lühemateks võrdse pikkusega segmentideks, millele järgneb iga lühema segmendi Fourier' teisenduse eraldi arvutamine. See paljastab iga lühema segmendi Fourier' spektri. Diskreetse aja signaalid on praktikas kasutatud. Vastav aeg-sagedus teisendus on diskreetne Fourier' teisendus, mis kirjeldab signaali Xn pikkust N koefitsiendi kompleksse väärtuse sageduspiirkonna esindajana. STFT, mis kirjeldab sageduskomponentide arengut aja jooksul, on üks enim kasutatavaid kõneanalüüsi ja -töötluse tööriistu [50]. Sarnaselt spektrile endale on STFT üheks eeliseks see, et selle parameetritel on füüsilised ja intuitiivsed tõlgendused. STFT-d visualiseeritakse tavaliselt logaritmi spektrite 20log10 (X(h, k)) abil. Selliseid 2D logaritmilisi spektreid saab seejärel vaadata spektrogrammina tuntud termokaardi abil. Algoritmi kolmandas etapis rakendatakse STFT spektraallülitusprotseduuri kaadritele, mis lastakse läbi kaaluakna. Signaali STFT saadakse akende avamisel ja iga akna DFT määramisel. Eelkõige määratakse sisendsignaali akende Xn ja Wn teisendus järgmiselt:

kus k-indeks vastab sagedusväärtustele ja wn on aknafunktsioon, mis on tavaliselt Hanningi aken või Gaussi aken, mille keskpunkt on null.
4.4. Mel Transform
Neljandas etapis jagatakse sagedusalale edastatav signaal kolmnurksete fifiltrite abil vahemikeks. Fifiltri piirid arvutatakse kriidisageduse abil. Üleminek kriidi sageduse fiväljale põhineb järgmisel võrrandil:

kus f on sagedusvahemik.
Tagurpidi lüliti määratakse järgmiselt:

Arvestage NN-d fifiltrite arvuna (tavaliselt kasutatakse 26 fifiltrit) ja flflows, mis on sama kõrge kui uuritav sagedusvahemik. See vahemik kantakse üle Meli skaalale ja jagatakse NN ühtlaselt jaotatud lõikuvateks vahemikeks. Lineaarsed sagedusele vastavad piirid määratakse fibri sees, fifiltratsiooni põhjal saadud kaalukoefitsiendid on tähistatud tähega H. Seejärel rakendatakse fifiltreid Fourier' teisendusest saadud koefitsientide ruutmoodulile. Saadud väärtused on logaritmilised järgmise avaldise tõttu:

Ainsuse väärtuse lagunemise algoritm rakendatakse MFCC-de arvutamise viimases etapis.
5. Katsetulemused
Rakendasime ja testisime pakutud meetodit rakenduses Visual Studio 2019 C plus plus arvutis, millel on 4,90 GHz protsessor, 32 GB muutmälu ja kaks Nvidia GeForce 2080Ti GPU-d, nagu on näidatud tabelis 4. Süsteemi testiti erinevates seadmekeskkondades, et hinnata signaali tunnuste eraldamise meetodi toimivust. Katsetes, algoritmi töötamise ajal (joonis 8), kui signaali pindade järjestus oli n=15, vähenes väärtuste arv 40–50 protsenti ja töötlemisaeg suurenes 1 võrra. 2-voldi. Järelikult näitas see algoritm oluliselt suuremat efektiivsust. Veelgi enam, see algoritm võimaldas Hanningi akna läbimisel vaikusealade eraldamist ja kõrvaldamist.
Mälu ribalaiuse raiskamise vältimiseks on saadaval mitu võimalust. Pakume välja uue lahenduse, mis suurendab andmetöötluse jõudlust, sobitades signaalikaadrite suuruse vahemälu plokisuurusega. Seda tüüpi optimeerimine võib märkimisväärselt mõjutada üldist paralleelse töötlemise jõudlust. Siiski saab seda kasutada digitaalses signaalitöötluses, jagades signaali mitmetuumaliste protsessorite rakenduste kaudu kaadriteks. Kuid praktikas tehakse valik tavaliselt väikeses mahus, mis vastab vahemälu põhimäluga ühendava andmesiini laiusele ja selle ploki suurusele. Meie meetod rakendab nende mälude optimaalset kasutamist paralleelarvutuses. Vahemälu korraldus mängib andmete voogudeks jagamisel paralleeltöötlusalgoritmide puhul olulist rolli. Eelkõige tuleks vektor-maatriksefektide olemasolu digitaalse signaalitöötluses ja nende voogude suurust kohandada vastavalt vahemäluplokkide suurusele. Seda saab saavutada pakutud meetodi abil, nagu on näidatud joonisel 9.
Tabel 4. Eksperimentaalse seadistuse üksikasjalikud kirjeldused.


joonis 8. (a) Esialgne sissetulev signaal ja (b) signaali ilmumine pärast pakutud algoritmi rakendamist.

Joonis 9. Paralleelarvutuse struktuur RK3288 protsessorite abil.
Selles jaotises käsitleme kvantitatiivset analüüsi, et võrrelda erinevate süsteemide toimivust. Võrdlesime oma meetodit tuntud kõnetuvastusalgoritmidega, mis põhinevad süvaõppe lähenemisviisidel. Hindamismõõdikud on olulised kõnetuvastuse erinevate strateegiate arvutamiseks ja erinevate lähenemisviiside toimivuse hindamiseks. Kuigi kasutasime võrdluseks teiste uuringute tulemusi, pole me kindlad, kas need vastavad tõele, sest nende meetodite lähtekoodid ja andmestikud ei ole tegeliku toimivuse kontrollimiseks avalikult kättesaadavad. Joonisel fig 10 on kujutatud vaiksete osade liigutamise tulemus kõnesignaali fragmendi läbimisel Hanningi aknast pakutud kiire algoritmi alusel. Analüüsist saadud kiiruse tulemused on toodud tabelis 5.
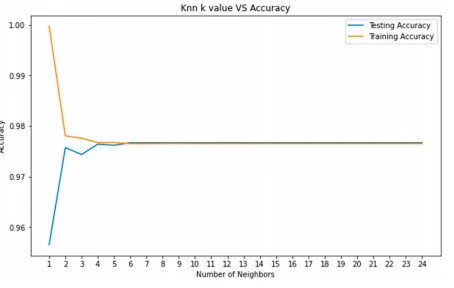
Joonis 10. KNN algoritmi k väärtus (koos tunnuse valikuga).
Tabel 5. Pakutud meetodi katsetulemused.

KNN-i algoritmi parima täpsuse väärtuse leidmiseks on määratud vahemik. Määratud vahemik hõlmab 1–25. Joonisel 10 on rakendatud KNN-i algoritmi graafik koos tunnuse valikuga. Kui graafikut uuriti, kui naabruskonna väärtus oli alguses 1, oli treeningu täpsus palju suurem kui testi täpsus. Korrelatsiooniga valitud funktsioonide abil loodud KNN-algoritmis määrati mudeli täpsuseks treeningu andmekogus 99,15 protsenti ja testandmekogus 97,35 protsenti.
Sõna veamäära (WER) või märgi veamäära kasutatakse tavaliselt kõnesignaalist funktsioonide eraldamise täpsuse hindamiseks. Need on objektiivsed maatriksid, millest on abi äratundmistehnikate õiglasel võrdlemisel. Varasemates uuringutes [51–56] arvutasime selliseid mõõdikuid nagu F-mõõt (FM), täpsus ja meeldetuletus. FM on kaalutud keskmine, mis tasakaalustab mõõtmisi täpsuse ja tagasikutsumise määra vahel. Täpsus on õigesti ennustatud positiivsete vaatluste arvu ja prognoositud positiivsete vaatluste koguarvu suhe. Tagasikutsumine on õigesti ennustatud positiivsete vaatluste arvu ja tegeliku klassi vaatluste koguarvu suhe, nagu on näidatud punktis (9). Funktsioonide eraldamise meetodite keskmise täpsuse ja tagasikutsumise määra arvutamiseks saab kasutada järgmisi võrrandeid:

kus TP tähistab tõeste positiivsete arvu, FP tähistab valepositiivsete arvu ja FN tähistab valenegatiivsete arvu.
FM arvutatakse kasutades (10), võttes arvesse nii täpsust kui ka tagasikutsumist.

Pakutud meetodi keskmine FM, tagasikutsumine ja täpsus oli 98,4 protsenti. Vale tuvastamine toimus 1,6 protsendil juhtudest mikrofoni signaalide soovimatu müra tõttu. Mudeli täpsuse vahemik oli vahemikus 0 kuni 1 ja meetrika hinnangulised skoorid saavutasid oma parimad väärtused 1. Meie meetodi ja teiste hiljuti avaldatud kõnetunnuste eraldamise meetodite hinnang on esitatud tabelis 6. Sama arv funktsioone kasutati õiglase võrdluse jaoks. Igast rühmast analüüsiti kokku 325 kõneproovi sarnase taustaga subjektidelt. Täpsuse parandamiseks uuriti ka erinevate kaadri pikkuste mõju vastavalt MFCC fifiltripankade arvule ja erinevate kaadri pikkuste mõju LPC järjekorras.
Tabel 6. Kõnetunnuste eraldamise kvantitatiivse täpsuse tulemused.

Nagu eelnevalt mainitud, on WER kõnetuvastuse jõudluse kõige levinum mõõt. See arvutatakse võrdlustranskriptsiooni ja kõnetuvastaja väljundi võrdlemisel. Selle võrdluse põhjal on võimalik arvutada vigade arv, mis tavaliselt kuuluvad kolme kategooriasse: (1) sisestused, kui sõna puudub automaatse kõnetuvastuse (ASR) väljundis, (2) kustutamised, kui sõna jääb ASR-i väljundis vahele, ja (3) asendused, kui sõna aetakse segi mõne teise sõnaga. WER-i saab arvutada järgmiselt.

kus S on valesti tuvastatud sõnade asenduste arv, D on kustutamiste arv, I on sisestuste arv ja N on sõnade arv võrdlustranskriptsioonis. Peamine probleem selle skoori arvutamisel on kahesõnaliste jadade joondamine. Seda saab määrata dünaamilise programmeerimise abil, kasutades Levenshteini kaugust [67].
Tabeli 6 alusel teostasime statistilise analüüsi, et näidata võrreldud meetodite keskmist täpsust WER-i hindamismõõdiku abil, nagu on näidatud joonisel 11. Täiustatud funktsioonide ekstraktija andis täpsuseks ligikaudu 98,4 protsenti , samas kui teised lähenemisviisid andsid täpsuse vahemikus 78 protsenti ja 96 protsenti . Võrdluseks kasutasime vastavates paberites toodud tulemusi; nende väärtuste täpsust ei ole aga lihtne kontrollida, kuna nende meetodite lähtekoodid ja andmestikud ei ole nende tegeliku toimimise kinnitamiseks avalikult kättesaadavad. Sellegipoolest demonstreeriti standardsete stseenide puhul eksperimentaalselt, et pakutud meetod tagab suurepärase kõnefunktsioonide eraldamise täpsuse, vähendades arvutusaega, isegi kui kõneandmed on mürarikkad või madala kvaliteediga.

Joonis 11. Kõnesignaali tunnuste eraldamise lähenemisviiside kvantitatiivsed tulemused vertikaalgraafikute abil.
Lisaks hindasime valitud meetodite valepositiivseid tulemusi. Nagu jooniselt 12 näha, oli pakutud lähenemisviisis kõige vähem vigu. Lisaks vähendas ülitõhus paralleelarvutusmeetod märkimisväärselt helisignaali funktsioonide valiku ja ekstraheerimise vigu. Treeningu ajal oli üks peamisi probleeme ülefitting, mille all kannatavad peaaegu kõik masinõppe mudelid. Üritasime vähendada ülepaigutamise riski, kasutades funktsioonide valiku tehnikat, mille eesmärk on andmekogus olemasolevate funktsioonide tähtsuse järjestamine ja vähemtähtsatest loobumine (uusi funktsioone ei looda).

Joonis 12. Valepositiivse kõnesignaali tunnuste eraldamise katsete nähtavad tulemused.
Tabelis 7 on toodud kõnetuvastuskeskkondades kasutatud meetodite toimivustulemused erinevate omaduste põhjal. Meie pakutud lähenemisviis ei kannata soovimatut ja tarbetut taustmüra ning seda ei mõjuta madala kvaliteediga inimhääled, nagu kähedad hääled, kurguvaluga tekitatud hääled või isegi inimeste helid, mille hääl on täielikult kadunud. Meie meetodi eesmärk on ületada ebapiisavate salvestusseadmete, taustamüra, keeruliste aktsentide ja murrete ning erinevate häälekõrguste probleemid. Tavakeskkonnas saadi parimad tulemused kõnefunktsioonide väljakutsete täpseks tuvastamiseks ja eraldamiseks, kasutades pakutud meetodit lühendatud töötlemisajaga.
Tabel 7. Kõnefunktsioonide tuvastamise ja eraldamise toimivuse ülevaade erinevate funktsioonide abil.

Kõnetuvastusmeetodite tulemused liigitati seitsme kategooria jaoks võimsateks, normaalseteks või nõrkadeks. Võimas kriteerium näitab, et algoritm suudab ületada kõikvõimalikud väljakutsed. Seevastu tavaline kriteerium näitab, et algoritm võib teatud juhtudel ebaõnnestuda, kuna sõnapiirid pole eelnevalt määratletud. Lõpuks viitab nõrk kriteerium sellele, et algoritm ei ole taustmüra või vibratsiooni korral usaldusväärne.
6. Piirangud
Raske on järeldada, et seni pakutud meetoditel ei ole puudusi. Meie pakutud meetod võib põhjustada ka erinevatest mürakeskkondadest tulenevaid vigu. Selle probleemi lahendamiseks püüdsime vähendada andmestiku funktsioonide arvu, luues olemasolevatest funktsioonidest uusi funktsioone [69]. Kuna võistluse käigus oli erinevate mudelite treenimisel üheks peamiseks probleemiks overfitting, siis treeningandmete rikastamine erinevate ressursside andmenäidiste lisamisega võiks olla üks võimalik lahendus tulemuste parandamisel. Sõltumata ülalnimetatud probleemidest näitasid katsetulemused, et meie meetod oli kõnefunktsioonide eraldamise ülesannete jaoks väga vastupidav ja tõhus, keskmise täpsusega 98,4 protsenti ja FM-ga 99,5 protsenti.
7. Järeldused
Kõnetuvastussüsteemide jaoks on pakutud välja uudne suure jõudlusega paralleelarvutusmeetod, mis kasutab masinõppemeetodit. Piiratud arvutusressurssidega masinate kiirendusprobleeme saab lahendada hajutatud süsteemide abil. Arvutuskiirust signaalituvastussüsteemides saab suurendada ja mitmetuumaliste platvormide jõudlust parandada, luues ja kasutades tõhusaid ja kiireid algoritme. Tulemused näitavad, et pakutud mudel vähendab töötlemisaega ja parandab funktsioonide eraldamise täpsust 98,4 protsenti, kasutades tõhusalt MFCC-sid. On täheldatud, et madalate korrelatsiooniväärtustega tunnused, mis on eraldatud tunnuste valikul, on mudeli edukuses samuti tõhusad. Eeltöödeldud andmetele viidi läbi statistiline analüüs ja andmetest saadi K-lähimatest naabritest (KNN) masinõppe algoritmi kasutades sisulist teavet.
Tulevased uuringud keskenduvad meie meetodi täpsuse parandamisele, kasutades süvaõppe lähenemisviise ja optimeerides mitmetuumaliste protsessorite vahemälu, et tuvastada ja eraldada kõnesignaale ilma olulise kvaliteedikaotuseta. Lisaks plaanime luua spektraalanalüüsi mudeli, mis põhineb paralleeltöötlusel ja millel on tugev analüüsijõudlus, mis võimaldab luua Tarise kõneandmekogumeid [70] kasutades madala arvutusressurssidega manustatud seadmeid 3D CNN-i ja 3D U-Net keskkonnas [71– 75]
Viited
1. Meng, YJ; Liu, WJ; Zhang, RZ; Du, HS kõnefunktsiooni parameetrite eraldamine ja tuvastamine interpoleerimisel. Rakendus Meh. Mater. 2014, 602–605, 2118–2123. [CrossRef] 2. Musaev, M.; Rakhimov, M. Accelerated Training for Convolutional Neural Networks. In Proceedings of the 2020 International Conference on Information Science and Communications Technologies (ICISCT), Taškent, Usbekistan, 4.–6.11.2020; lk 1–5. [CrossRef] 3. Ye, F.; Yang, J. Kõlari tuvastamise sügav närvivõrgu mudel. Rakendus Sci. 2021, 11, 3603. [CrossRef] 4. Musaev, M.; Rakhimov, M. Meetod põhimälu ploki kaardistamiseks vahemällu kõnesignaali paralleelsel töötlemisel. In Proceedings of the 2019 International Conference on Information Science and Communications Technologies (ICISCT), Karachi, Pakistan, 9.–10. märts 2019; lk 1–4. [CrossRef] 5. Jiang, N.; Liu, T. Täiustatud kõne segmenteerimise ja rühmitamise algoritm, mis põhineb SOM-il ja k-keskmisel. matemaatika. Probl. Eng. 2020, 2020, 3608286. [CrossRef] 6. Hu, W.; Yang, Z.; Chen, C.; Sun, B.; Xie, Q. Vibratsiooni segmenteerimise lähenemisviis arvjuhtimistorni mitmetoimelisele süsteemile. Signaalpildi videoprotsess. 2021, 16, 489–496. [CrossRef]
7. Popescu, TD; Aiordachioaie, D. Veerelaagrite rikete tuvastamine vibreerivate signaalide optimaalse segmenteerimise abil. Meh. Syst. Signaaliprotsess. 2019, 116, 370–391. [CrossRef] 8. Shihab, MSH; Aditya, S.; setu, JH; Imtiaz-Ud-Din, KM; Efat, MIA Hübriidne GRU-CNN-i funktsioonide eraldamise tehnika kõlarite tuvastamiseks. In Proceedings of the 2020 23rd International Conference on Computer and Information Technology (ICCIT), Dhaka, Bangladesh, 19.–21. detsember 2020; lk 1–6. [CrossRef] 9. Korkmaz, O.; Atasoy, A. Emotsioonide tuvastamine kõnesignaalist mel-sageduslike tsepstrikoefitsientide abil. In Proceedings of the 9th International Conference on Electrical and Electronics Engineering (ELECO), Bursa, Türgi, 26.–28.11.2015; lk 1254–1257. 10. Ayvaz, U.; Gürüler, H.; Khan, F.; Ahmed, N.; Whangbo, T.; Abdusalomov, A. Automaatne kõlarite tuvastamine, kasutades Mel-Frequency tsepstral koefitsiente masinõppe kaudu. CMC-arvuti. Mater. Jätka. 2022, 71, 5511–5521. 11. Al-Qaderi, M.; Lahamer, E.; Rad, A. Kahetasandiline kõlarite identifitseerimissüsteem heterogeensete klassifikaatorite ja täiendavate funktsioonide koostöö kaudu. Andurid 2021, 21, 5097. [CrossRef] 12. Batur Dinler, Ö.; Aydin, N. Speech Segment Detection jaoks mõeldud optimaalne funktsiooni parameetrite komplekt, mis põhineb korduvatel korduvatel üksustel korduvatel närvivõrkudel. Rakendus Sci. 2020, 10, 1273. [CrossRef] 13. Kim, H.; Shin, JW kahe mikrofoniga kõne täiustamine, mis põhineb TF-GSC-l koos lekke summutamise ja signaali taastamisega. Rakendus Sci. 2021, 11, 2816. [CrossRef] 14. Lee, S.-J.; Kwon, H.-Y. Kõnesegmendi tuvastamisel põhinev kõneandmete müra summutamise eeltöötlusstrateegia. Rakendus Sci. 2020, 10, 7385. [CrossRef] 15. Rusnac, A.-L.; Grigore, O. CNN Arhitektuurid ja funktsioonide eraldamise meetodid EEG kujuteldava kõnetuvastuse jaoks. Andurid 2022, 22, 4679. [CrossRef] [PubMed] 16. Wafa, R.; Khan, MQ; Malik, F.; Abdusalomov, AB; Cho, YI; Odarchenko, R. Agiilse metoodika mõju projekti edule, inimese töökohale sobivuse modereeriv roll Pakistani IT-tööstuses. Rakendus Sci. 2022, 12, 10698. [CrossRef] 17. Aggarwal, A.; Srivastava, A.; Agarwal, A.; Chahal, N.; Singh, D.; Alnuaim, AA; Alhadlaq, A.; Lee, H.-N. Kahesuunaline funktsioonide eraldamine kõneemotsioonide tuvastamiseks süvaõppe abil. Andurid 2022, 22, 2378. [CrossRef] [PubMed] 18. Marini, M.; Vanello, N.; Fanucci, L. Kõlaritest sõltuvate funktsioonide ekstraheerimise parameetrite optimeerimine düsartriaga inimeste automaatse kõnetuvastuse toimivuse parandamiseks. Andurid 2021, 21, 6460. [CrossRef] 19. Tiwari, S.; Jain, A.; Sharma, AK; Almustafa, KM Fonokardiogrammi signaalipõhine mitmeklassiline südamediagnostika otsuste tugisüsteem. IEEE Access 2021, 9, 110710–110722. [CrossRef] 20. Mohtaj, S.; Schmitt, V.; Möller, S. Funktsioonide eraldamisel põhinev vihkamiskõne tuvastamise mudel. arXiv 2022, arXiv: 2201.04227. 21. Kuldošbay, A.; Abdusalomov, A.; Mukhiddinov, M.; Baratov, N.; Makhmudov, F.; Cho, YI CNN-is kasutatava ultrahelipiltide automaatse klassifitseerimismeetodi täiustus. Int. J. Wavelets Multiresolution Inf. Protsess. 2022, 20, 2150054. 22. Passricha, V.; Aggarwal, RK Sügava CNN-i ja kahesuunalise LSTM-i hübriid automaatseks kõnetuvastuseks. J. Intell. Syst. 2020, 29, 1261–1274. [CrossRef] 23. Mukhamadijev, A.; Hudžajarov, I.; Djurajev, O.; Cho, J. Usbeki keele süvaõppe lähenemisviisidel põhinev automaatne kõnetuvastusmeetod. Andurid 2022, 22, 3683. [CrossRef] [PubMed] 24. Li, F.; Liu, M.; Zhao, Y.; Kong, L.; Dong, L.; Liu, X.; Hui, M. Südameheli tunnuste eraldamine ja klassifitseerimine 1D-konvolutsiooniliste närvivõrkude abil. EURASIP J. Adv. Signaaliprotsess. 2019, 2019, 59. [CrossRef] 25. Chang, L.-C.; Hung, J.-W. Esialgne uuring robustsete kõnefunktsioonide eraldamise kohta, mis põhineb olekute tõenäosuse maksimeerimisel sügavakustilistes mudelites. Rakendus Syst. Innov. 2022, 5, 71. [CrossRef] 26. Ramírez, J.; Górriz, JM; Segura, JC häältegevuse tuvastamine. Põhialused ja kõnetuvastussüsteemi töökindlus. Tugev kõnetuvastus ja -mõistmine; Grimm, M., Kroschel, K., toim.; I-TECH haridus ja kirjastamine: London, UK, 2007; lk 1–22. 27. Oh, S. DNN-il põhinev jõuline kõnefunktsioonide eraldamine ja signaalimüra eemaldamise meetod, mis kasutab kõnetuvastuse jaoks täiustatud keskmise prognoosimise LMS-filtrit. J. Converg. Info Technol. 2021, 11, 1.–6. [CrossRef] 28. Abbaschian, BJ; Sierra-Sosa, D.; Elmaghraby, A. Kõneemotsioonide tuvastamise süvaõppetehnikad andmebaasidest mudeliteni. Andurid 2021, 21, 1249. [CrossRef] 29. Rakhimov, M.; Mamadjanov, D.; Mukhiddinov, A. Suure jõudlusega paralleelne lähenemine pilditöötlusele hajutatud andmetöötluses. In Proceedings of the 2020 IEEE 14th International Conference on Application of Information and Communication Technologies (AICT), Usbekistan, Taškent, 7.–9. oktoober 2020; lk 1–5. [CrossRef] 30. Abdusalomov, A.; Mukhiddinov, M.; Djurajev, O.; Khamdamov, U.; Whangbo, TK Automaatne silmapaistvate objektide ekstraheerimine, mis põhineb lokaalselt adaptiivsel läviväärtusel puutetundliku graafika loomiseks. Rakendus Sci. 2020, 10, 3350. [CrossRef] 31. Abdusalomov, A.; Whangbo, TK Esiplaani tuvastamise meetodi täiustus, kasutades sisekeskkonna varjude eemaldamise tehnikat. Int. J. Wavelets Multiresolution Inf. Protsess. 2017, 15, 1750039. [CrossRef] 32. Abdusalomov, A.; Whangbo, TK Liikuvate objektide varjude tuvastamine ja eemaldamine, kasutades siseruumides kasutatavate videovoogude jaoks geomeetria- ja värviteavet. Rakendus Sci. 2019, 9, 5165. [CrossRef] 33. Mery, D. Computer Vision for X-ray Testing; Springer International Publishing: Cham, Šveits, 2015; lk. 271, ISBN 978-3319207469. 34. Mark, S. Kõnekujutised kalibreerivad ümber kõne-taju piirid. Tähelepanu. Taju. Psühhofüüsid. 2016, 78, 1496–1511. [CrossRef] 35. Mudgal, E.; Mukuntharaj, S.; Modak, MU; Rao, YS mallipõhine reaalajas kõnetuvastus, kasutades DSP-TMS320F28335 digitaalfiltreid. In Proceedings of the 2018 Fourth International Conference on Computing Communication Control and Automation (ICCUBEA), Pune, India, 16.–18. august 2018; lk 1–6. [CrossRef]


